Pular para o conteúdo principal

EXTRAÇÃO DE DADOS COM IA

Pipelines que se adaptam sozinhos — dados estruturados, em escala

Extração de dados de sites e APIs com apoio de IA

O seu time gasta horas toda semana coletando dados à mão, e os scripts que deveriam ajudar quebram sempre que uma fonte muda. Um time corporativo de analytics (500 a 1.000 funcionários) reduziu dados ruins em 20% a 30% e melhorou a velocidade de validação em 30% a 40% depois de implantar os nossos pipelines em Rust; um cliente de dados de e-sports viu 90% menos carga de trabalho e ingestão 20x mais rápida.

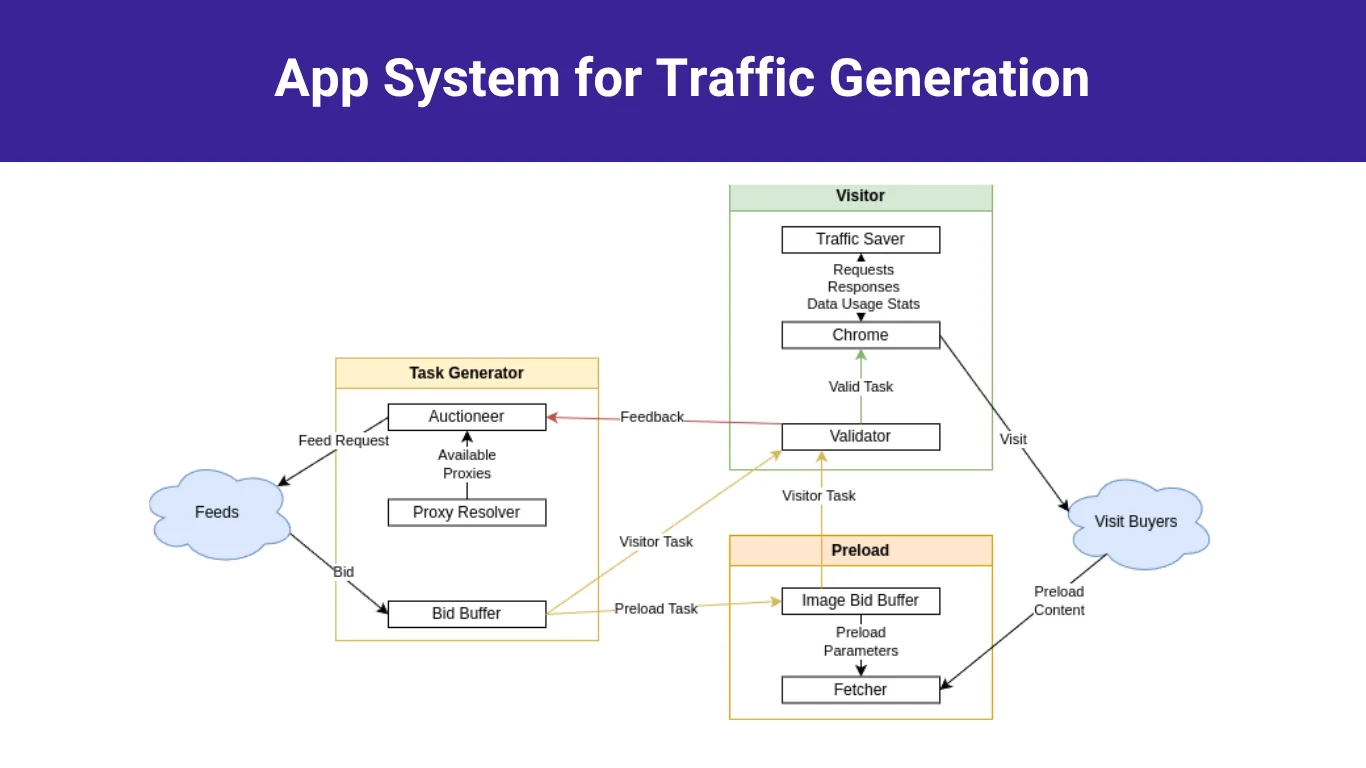
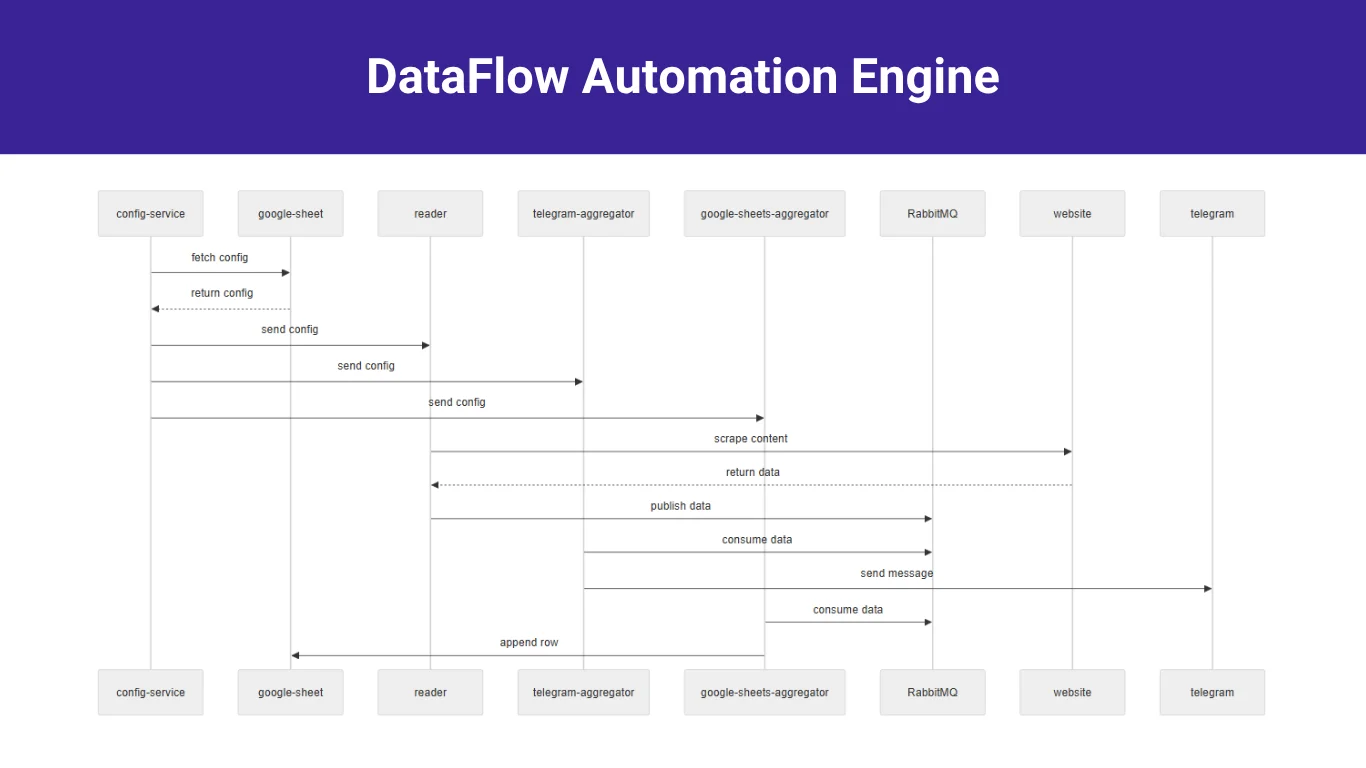
Extraímos dados estruturados de sites, APIs e plataformas sociais — limpos, formatados e entregues exatamente na estrutura que você precisa. A infraestrutura com IA cuida da adaptação por ML/LLM, rotação de proxies, resolução de CAPTCHA e impressão digital de navegador — pipelines que se adaptam quando a fonte muda, não scripts frágeis que quebram a cada atualização. O pipeline é seu: código-fonte, configuração de infraestrutura e documentação, sem amarra a SaaS.

Podemos ajudar com:

  • Scraping de sites e de e-commerce
  • Coleta de dados públicos e de redes sociais
  • Integração de APIs e extração de dados brutos
  • Monitoramento de preços e acompanhamento de produtos
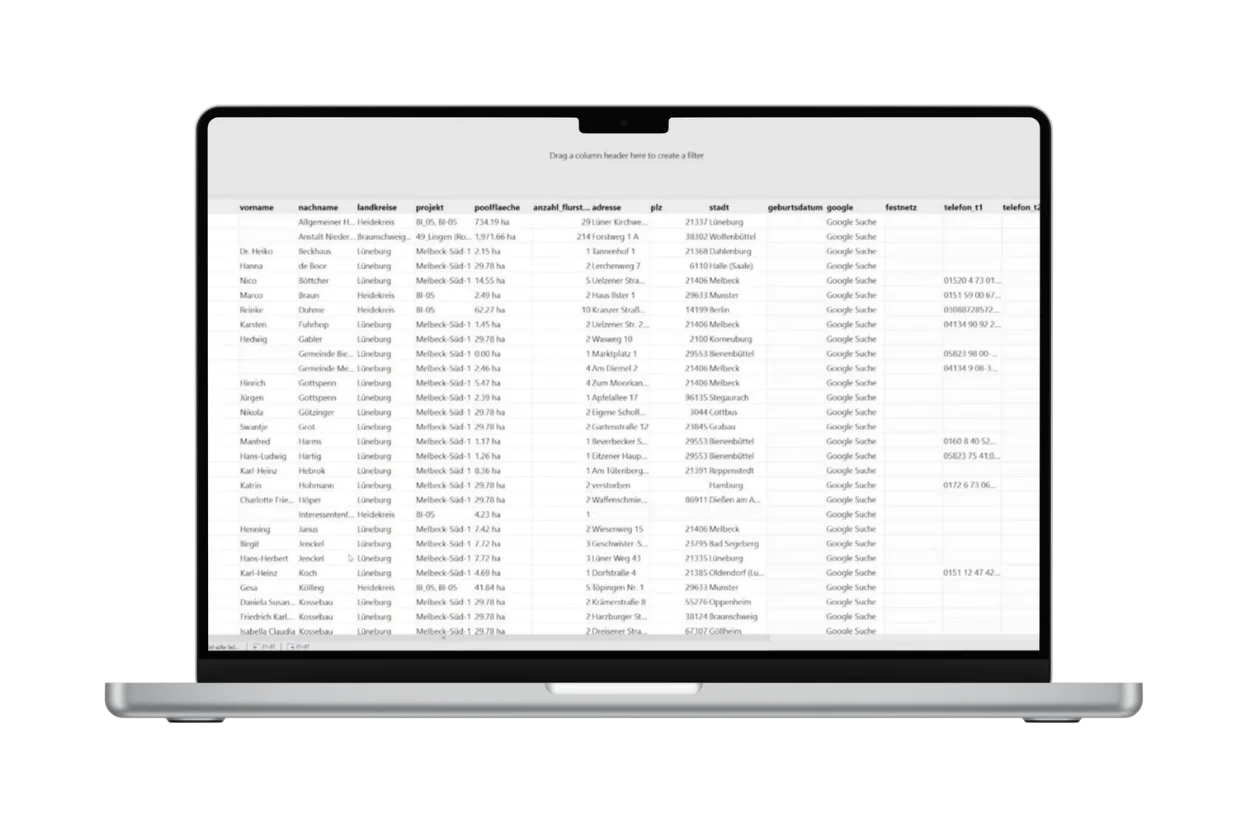
  • Vagas, imóveis e dados cadastrais de empresas
  • Limpeza, formatação e pré-processamento de dados
  • Pipeline de automação de processamento de dados
  • Geração automatizada de leads
  • e mais.

Pronto para falar sobre um pipeline de dados confiável para o seu caso? Agende uma conversa gratuita!

Tecnologias que usamos

  • Python
    Python
  • Selenium
    Selenium
  • Pandas
    Pandas
  • TensorFlow
    TensorFlow
  • n8n
    n8n
  • Rust
    Rust
  • Skyvern
    Skyvern
  • Relevance AI
    Relevance AI
  • Manus
    Manus
  • Airtable
    Airtable
  • Vertex AI
    Vertex AI

Pacotes

Uma conversa sobre as fontes que você precisa ler: como elas são defendidas, com que frequência mudam e o que é um registro limpo para você.

1 dia

Puxamos uma amostra de cada fonte que você indicar e mostramos o que sobrevive ao parsing, antes de escrever uma linha de automação.

7 dias

Pipeline de extração com escopo definido — scripts sob medida, saída estruturada, implantado e automatizado.

30 dias

Uma plataforma de extração mantida funcionando contra fontes que mudam: novos formatos, novos sites, novos esquemas e o ciclo de revisão que pega o desvio cedo.

90+ dias

Estudos de Caso

Perguntas frequentes

  • Entregamos soluções de scraping confiáveis e de alta qualidade, sem exigir supervisão constante. Construímos pipelines que processam milhões de registros atravessando proteções antibot, APIs com limite de taxa e páginas renderizadas dinamicamente.

  • Testamos os scripts com rigor para garantir que capturem dados corretos e completos. Além disso, podemos entregar uma amostra dos dados coletados para a sua revisão antes da entrega final.

  • Se o site muda com frequência, construímos um script desenhado especificamente para isso. Assim você coleta os dados mais recentes com a periodicidade que precisar — de hora em hora, diariamente ou em um cronograma próprio.

  • O Skyvern automatiza fluxos de navegador com IA, adaptando-se a mudanças de layout em tarefas como preenchimento de formulários e extração de dados, com implantação local ou em nuvem. O Relevance AI nos permite criar agentes de IA com ferramentas low-code para automatizar tarefas, mantendo segurança e eficiência nos fluxos.

  • Dá. Em vez de um investimento inicial grande, você pode optar por assinatura. Você paga por uma solução pronta para uso com garantias adicionais. Isso dilui a despesa e inclui suporte — verificações de segurança, atualizações e resolução de problemas.

  • Projetos de scraping têm um risco conhecido: sites-alvo mudam de layout. Construímos seletores resilientes e incluímos monitoramento em toda entrega. Os orçamentos por marco são fixos, com escopo claro — se um site exigir engenharia reversa adicional, sinalizamos o impacto de custo antes de seguir.

  • Um cliente corporativo de analytics (500 a 1.000 funcionários) embutiu os nossos pipelines de transformação em Rust no ETL PySpark existente — reduzindo dados ruins em 20% a 30% e melhorando a velocidade de validação em 30% a 40%. Automatizamos um pipeline de scraping que reduziu a coleta manual em 90% e cortou custos de API em 80%. Em outro projeto, construímos um motor de ingestão de dados de e-sports com vazão 20x maior usando Rust e ClickHouse.

  • Sim. Assinamos NDA antes de qualquer conversa técnica, mediante solicitação.

  • Seu. Propriedade intelectual, código-fonte, documentação de arquitetura e runbooks de implantação são integralmente cedidos a você na conclusão — sem dependência de fornecedor.

  • Sim. Contratos assinados com escopo fixo por fase. Você contrata uma pessoa jurídica registrada, não um indivíduo.

Conversa gratuita

Converse com a nossa equipe de engenharia e encontre a solução certa para a sua necessidade.

Agendar conversa
30 minutos