Pular para o conteúdo principal

VISÃO COMPUTACIONAL

Mais de 95% de precisão em campo — otimizado para CUDA, pronto para produção

De pixels brutos a inteligência em produção — precisão real, em escala.

Análise manual de imagens não escala — e contratar mais gente não resolve quando o custo de inferência está explodindo. Construímos visão computacional pronta para produção que sustenta mais de 95% de precisão em condições reais, processando milhares de quadros abaixo de 250ms cada. Da detecção de objetos em tempo real à segmentação com precisão de pixel, entregamos resultados que sobrevivem à carga de produção.

Aceleração CUDA, otimização para TPU de borda e inferência em contêiner — não notebooks Jupyter. De ponta a ponta: curadoria de dados, treinamento, implantação, retreinamento via CI/CD e detecção de desvio. Comprovado: controle de qualidade industrial com milhões de imagens por dia e menos de 250ms por quadro em 4 fluxos simultâneos sobre hardware comum, sem depender de GPU em nuvem (Gary Gergen, Tethys Ocean LLC). O modelo e o pipeline são seus — em contêiner, documentados, implantáveis em qualquer lugar.

Podemos ajudar com:

  • Detecção e reconhecimento de objetos
  • Processamento de imagem e vídeo (extração de características, segmentação, realce)
  • Segmentação e classificação de imagens (CNNs, modelos ViT, análise por pixel)
  • Reconhecimento de faces e de características
  • Estimativa de pose e reconhecimento de gestos
  • Geração e realce de imagens com IA
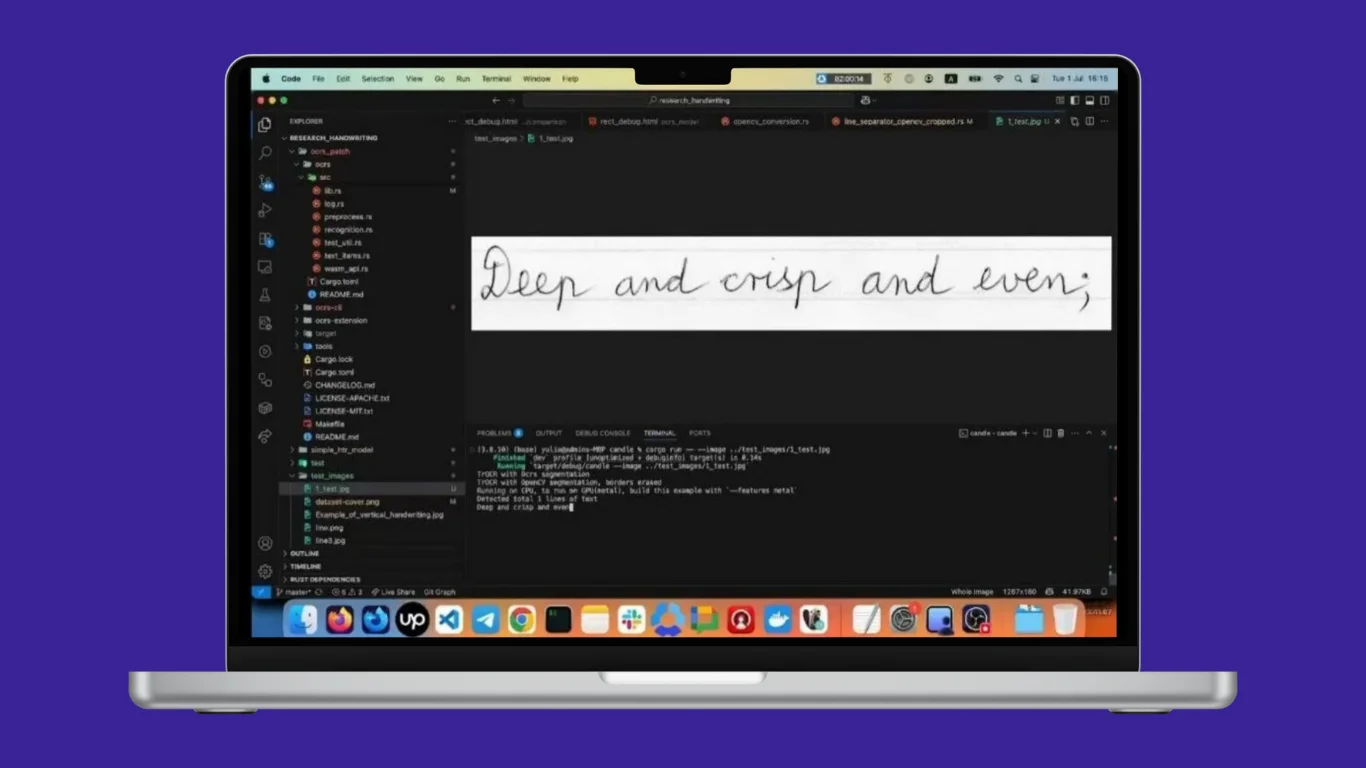
  • Segmentação de manuscrito
  • Preparação de dados e seleção de modelos (conjuntos Kaggle/HuggingFace)
  • Otimização de hardware e implantação (CUDA, dispositivos de borda, inferência em nuvem)
  • e mais.

Pronto para falar sobre um pipeline de visão computacional em produção para o seu caso? Agende uma conversa gratuita!

Tecnologias que usamos

  • Python
    Python
  • C++
    C++
  • Rust
    Rust
  • PyTorch
    PyTorch
  • TensorFlow
    TensorFlow
  • Keras
    Keras
  • OpenCV
    OpenCV
  • OCR
    OCR
  • CUDA
    CUDA
  • YOLO
    YOLO
  • MediaPipe
    MediaPipe

Pacotes

Uma conversa sobre as imagens ou vídeos que você tem: o que precisa ser reconhecido, com que precisão e com que rapidez.

1 dia

Rotulamos uma amostra, treinamos um modelo descartável sobre ela e relatamos a precisão que os seus próprios dados realmente sustentam.

7 dias

Modelo de visão com escopo definido — treinado nos seus dados, testado, implantado. Pipeline de inferência incluído.

30 dias

Um sistema de visão levado à produção e mantido lá — coleta de dados, retreinamento, implantação na borda e o número de precisão pelo qual você o mede.

90+ dias

Estudos de Caso

Perguntas frequentes

  • Ajustamos a complexidade do modelo (CNN, YOLO, ViT) ao seu hardware — GPUs CUDA, TPUs de borda ou clusters em nuvem. Depois medimos latência, vazão e consumo. A implantação usa microsserviços em contêiner, autoescala e monitoramento em tempo real para inferência de baixa latência e custo controlado.

  • Não. Estruturamos o trabalho em marcos claros — P&D, prova de conceito, treinamento, integração, QA — com relatórios de progresso digeríveis. Os nossos engenheiros cuidam do detalhe técnico, e um gerente dedicado (ou o CTO, se você preferir) acompanha qualidade e prazo.

  • Cada marco inclui QA cruzado, revisão de código e validação de desempenho em conjuntos de teste reservados. Entregamos código documentado, pipelines de CI/CD para retreinamento e ganchos de detecção de desvio. O suporte contínuo garante que os modelos evoluam com novos dados e mudanças de uso.

  • Aplicamos criptografia de ponta a ponta (AES-256) em trânsito e em repouso, anonimizamos características sensíveis (rostos, placas) sob demanda e atendemos à LGPD e a outras regulações aplicáveis. Os modelos podem ser implantados no seu próprio ambiente ou em VPC privada, garantindo soberania total dos dados.

  • Sim, designamos um gerente que pode falar diretamente com você ou atuar nos bastidores. Para clientes que preferem contato direto com o time, o gerente garante consistência enquanto você interage diretamente com os desenvolvedores.

  • Projetos de ML carregam incerteza na precisão do modelo. Mitigamos isso definindo métricas de sucesso (precisão, revocação, latência) na descoberta e validando contra conjuntos reservados a cada marco. Se um modelo não converge, sinalizamos alternativas cedo — não depois de seis semanas de treinamento.

  • Construímos um pipeline de visão em tempo real processando vídeo abaixo de 250ms por quadro em 4 fluxos simultâneos. O sistema reduziu a carga cognitiva do operador em 75% enquanto registrava mais de 10 mil quadros analisados — tudo em hardware comum, sem depender de GPU em nuvem.

  • Sim. Assinamos NDA antes de qualquer conversa técnica, mediante solicitação.

  • Seu. Propriedade intelectual, código-fonte, modelos treinados e runbooks de implantação são integralmente cedidos a você na conclusão — sem dependência de fornecedor.

  • Sim. Contratos assinados com escopo fixo por fase. Você contrata uma pessoa jurídica registrada, não um indivíduo.

Conversa gratuita

Converse com a nossa equipe de engenharia e encontre a solução certa para a sua necessidade.

Agendar conversa
30 minutos